Timestamps: o que é e quando usar a marcação por palavra ou por segmento
Dzianis Kukareka, Fundador · Atualizado
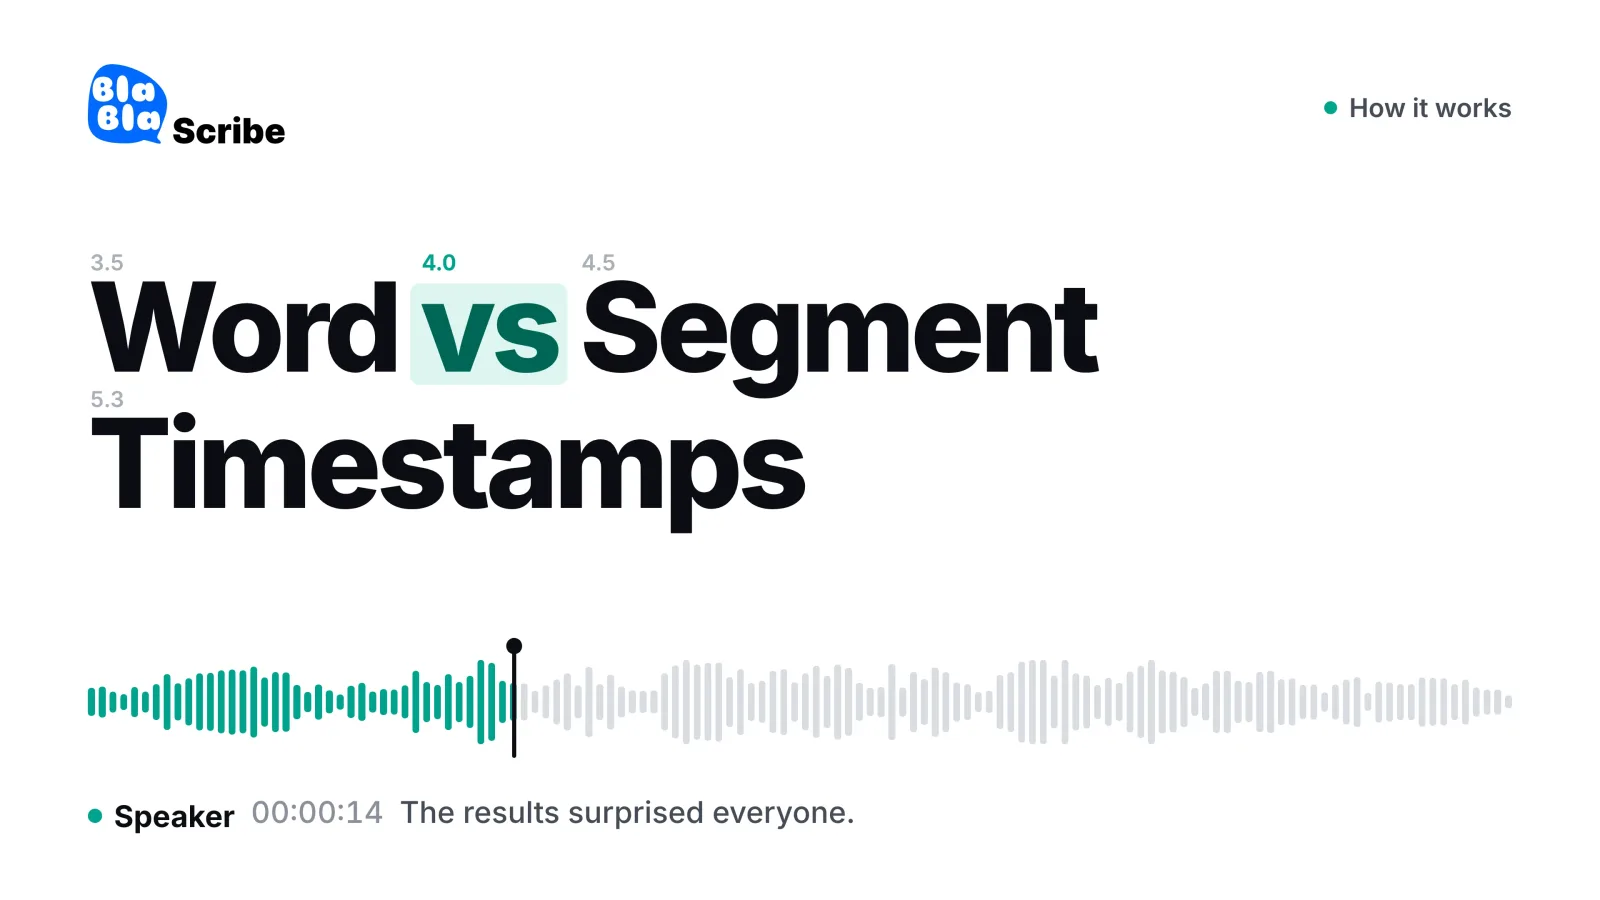
Timestamps são as marcações de tempo que ligam o texto da transcrição ao momento exato em que ele foi falado, e existem em duas resoluções. Os timestamps por segmento dão a cada frase um único tempo de início e de fim, e é disso que legendas, transcrições para revisão e listas de capítulos precisam. Os timestamps por palavra dão a cada palavra o seu próprio início e fim, o que só faz diferença quando um software age sobre palavras individuais: legendas no estilo karaokê, edição pelo texto, cortes precisos de trechos ou análise de fala.
Se você não está construindo nenhum desses recursos, a marcação por segmento é o padrão certo. O restante deste guia mostra como cada tipo se parece, como colocar timestamps numa transcrição à mão ou de forma automática, como ferramentas como o Whisper geram o tempo de cada palavra e quais formatos de arquivo conseguem guardar essa informação.
Timestamps: o que é a marcação de tempo numa transcrição?
Marcar o tempo é inserir códigos de tempo na transcrição para que o leitor possa pular de uma linha do texto para o mesmo ponto da gravação. Um timestamp costuma ser escrito em horas, minutos e segundos, por exemplo [00:14:32], e os arquivos de legenda acrescentam milissegundos: 00:14:32.480.
Os timestamps têm três funções. Permitem conferir uma citação com o áudio, permitem citar ou linkar um momento (um capítulo, um item das show notes, um trecho de pesquisa) e permitem que um player ou editor sincronize texto e som. A função que você tem em mãos define a densidade de marcações necessária.
Quais são os tipos de timestamps numa transcrição?
Quatro convenções dão conta de quase todas as transcrições que você vai encontrar. As duas primeiras são comuns em transcrições digitadas por pessoas; as duas últimas vêm de software.
| Tipo | Onde aparece o código de tempo | Uso típico | Exemplo |
|---|---|---|---|
| Por intervalo | Num ritmo fixo, por exemplo a cada 30 ou 60 segundos | Entrevistas longas e aulas em que basta uma navegação aproximada | [00:05:00] |
| Por troca de falante | Sempre que outra pessoa começa a falar | Entrevistas, grupos focais, registros de reunião | [00:05:12] Anna: |
| Por segmento (cue) | Início e fim de cada frase ou oração | Legendas, transcrições clicáveis, capítulos | 00:05:12.400 --> 00:05:15.900 |
| Por palavra | Início e fim de cada palavra | Legendas animadas, edição pelo texto, análises | results 312.61–312.98 |
Transcrições de pesquisa muitas vezes combinam as duas primeiras: um timestamp a cada turno de fala e outro a cada minuto nos monólogos longos. Assim a página continua legível, e quem codifica ainda encontra qualquer trecho em segundos.
Timestamp por palavra ou por segmento: como cada um se parece
Esta é uma frase em resolução de segmento, no formato que todo editor de legendas usa:
00:01:22.400 --> 00:01:25.900
The results surprised everyone on the team.
E o mesmo áudio em resolução de palavra, do jeito que uma transcrição típica em JSON o armazena (resumido):
[
  {"word": "The",       "start": 82.40, "end": 82.58},
  {"word": "results",   "start": 82.61, "end": 82.98},
  {"word": "surprised", "start": 83.05, "end": 83.47},
  {"word": "everyone",  "start": 83.52, "end": 83.86},
  ...
]
A versão por segmento é uma linha que uma pessoa lê. A versão por palavra são sete registros sobre os quais um programa consegue agir. As duas descrevem os mesmos 3,5 segundos; o que muda é a resolução, não a fidelidade.
Quando os timestamps por segmento bastam?
Para a maioria das entregas que alguém vai ler ou assistir, o segmento é a granularidade correta.
Legendas e closed captions. Uma cue é um segmento: uma frase que fica na tela o tempo suficiente para ser lida. O guia de estilo da Netflix, por exemplo, fixa um mínimo de cinco sextos de segundo e um máximo de sete segundos por evento de legenda (Netflix Timed Text Style Guide). Tempo por palavra não acrescenta nada a uma cue que respeita esses limites. O trabalho de verdade está nas quebras de linha e na velocidade de leitura, tema do nosso guia sobre o tamanho da linha de legenda.
Revisão e citações. Conferir uma citação numa entrevista ou uma decisão numa ata de reunião significa clicar numa frase e ouvi-la. A resolução de frase já leva você até lá.
Capítulos e show notes. Os capítulos do YouTube exigem uma lista na descrição que comece em
00:00, tenha pelo menos três timestamps em ordem crescente e capítulos de no mínimo 10 segundos (Ajuda do YouTube). Ninguém precisa de tempo por palavra com precisão de milissegundos para isso.Busca numa gravação. Uma busca que cai no segmento certo deixa você a poucos segundos do termo; o ouvido faz o resto.
Quando você precisa de timestamps por palavra?
O tempo por palavra se justifica quando um recurso simplesmente não funciona sem ele.
Legendas palavra por palavra. O estilo comum no TikTok, nos Reels e nos Shorts, em que cada palavra salta ou muda de cor no momento em que é dita, precisa saber quando cada palavra começa.
Transcrições para acompanhar a leitura. Players de podcast e de aulas que destacam a palavra atual enquanto o áudio toca seguem os tempos de cada palavra.
Edição pelo texto. Apagar uma frase na transcrição e ver o áudio cortado no mesmo ponto depende do alinhamento entre palavra e áudio.
Cortes justos de trechos. Clipes automáticos que começam exatamente na primeira palavra de uma citação, sem meio segundo de respiração antes, usam o tempo de início das palavras.
Análise de fala. Velocidade da fala, duração das pausas e sobreposição entre falantes são calculadas a partir dos tempos das palavras.
Um teste rápido: se você não consegue apontar o recurso que vai ler os tempos por palavra, você não precisa deles. Guardá-los mesmo assim não custa nada na maioria das ferramentas, mas mostrá-los aos leitores deixa a transcrição mais difícil de usar.
Por palavra ou por segmento: comparação rápida
| Por segmento | Por palavra | |
|---|---|---|
| Resolução | Frase ou oração | Cada palavra |
| Formatos nativos | SRT, VTT, transcrições em DOCX/TXT | Arrays de palavras em JSON, timestamps dentro das cues do VTT |
| Quem lê | Pessoas | Software |
| Legendas | Padrão | Só para estilos animados palavra a palavra |
| Conferência de citações | Ideal | Desnecessário |
| Edição pelo texto, cortes | Grosseiro demais | Obrigatório |
| Sensibilidade a áudio ruim | Baixa: os limites caem nas pausas | Maior: palavras emboladas ou sobrepostas recebem tempos aproximados |
Como colocar timestamps numa transcrição
Se você digita a transcrição à mão, ter uma convenção consistente importa mais do que qual convenção você escolhe. Um procedimento que funciona:
Defina o formato uma vez só. Use
[hh:mm:ss]entre colchetes em documentos. Acrescente milissegundos apenas em arquivos de legenda, onde o formato exige.Defina o gatilho. Marque o tempo a cada troca de falante, a cada intervalo fixo (30 ou 60 segundos é o mais comum) ou nos dois casos. Escreva a regra no topo do documento para que os outros leitores saibam o que significa a falta de um timestamp.
Leia o tempo no player, não de cabeça. Pause, anote a posição atual e digite-a no começo da linha.
Marque lacunas e trechos inaudíveis também com o tempo, por exemplo
[inaudível 00:12:41], para que quem revisa vá direto ao problema.Faça uma verificação por amostragem no final. Pule para três ou quatro timestamps e confirme que o texto bate com o que você ouve.
Fazer isso à mão para uma hora de áudio é lento, e por isso a maioria das pessoas hoje deixa o reconhecimento de fala posicionar os timestamps e corrige só o texto. Uma ferramenta de transcrição com IA entrega uma transcrição em que cada segmento já traz o seu código de tempo. O BlaBlaScribe funciona assim com arquivos enviados e links (por exemplo, pelo gerador de transcrição do YouTube), com precisão de até 99,8% em áudio limpo, e exporta SRT, VTT, DOCX, TXT, JSON e outros formatos. Ele não é um bot de reunião, não entra em chamadas ao vivo e não tem API pública; se você precisa de arrays de palavras chegando direto no seu software, uma API de fala para desenvolvedores é a escolha mais adequada.
Como funcionam os timestamps por palavra do Whisper?
Os modelos de fala não ouvem uma palavra num único instante. Eles avaliam o áudio em quadros curtos e emitem tokens de texto à medida que as evidências se acumulam. Os timestamps por palavra surgem quando esses tokens são mapeados de volta para os quadros, uma etapa chamada alinhamento. Há duas formas comuns de fazer isso.
A partir da própria atenção do modelo. O Whisper, modelo de código aberto da OpenAI, tem a opção
word_timestamps, que, nas palavras do próprio código-fonte, extrai timestamps por palavra "using the cross-attention pattern and dynamic time warping" (Whisper, transcribe.py). A ajuda da linha de comando ainda classifica a opção como experimental. Com ela ativada, o Whisper também consegue sublinhar cada palavra no momento em que é falada nas saídas SRT e VTT.Alinhamento forçado numa segunda passada. Um modelo separado pega o texto pronto e o áudio e encontra a melhor correspondência entre eles, fonema por fonema. É o caminho do WhisperX, que combina detecção de atividade de voz com alinhamento forçado de fonemas; os autores observam que os timestamps de enunciado do Whisper são propensos a imprecisões e que timestamps por palavra não vêm prontos de fábrica (Bain et al., WhisperX, 2023).
As APIs comerciais oferecem a mesma ideia como opção de requisição. O Google Cloud Speech-to-Text, por exemplo, devolve os tempos de início e fim de cada palavra quando enableWordTimeOffsets está definido como true, em incrementos de 100 ms (documentação do Google Cloud). Essa granularidade serve para destacar palavras, mas é grosseira demais para confiar em edições de áudio com precisão de quadro sem uma conferência.
Por que os timestamps do Whisper às vezes ficam imprecisos?
As causas costumam ser as mesmas que prejudicam a precisão da transcrição em geral. A fala encadeada borra os limites entre as palavras ("tá", "pra", "cê"), falantes sobrepostos disputam o mesmo trecho de áudio, música e ruído apagam os inícios das palavras, e silêncios longos ou texto alucinado podem tirar de sincronia os segmentos seguintes. Em áudio ruim, os tempos por palavra tendem a ser aproximados palavra a palavra e confiáveis frase a frase. Se o tempo começar a escorregar, limpe o áudio primeiro, divida arquivos muito longos e use uma ferramenta que faça uma passada dedicada de alinhamento. Para entender como o reconhecimento funciona por dentro, veja como a conversão de fala em texto funciona de verdade e a nossa comparação entre o Whisper e as ferramentas de transcrição pagas.
Quais formatos de arquivo guardam timestamps por palavra?
O SRT só trabalha com segmentos. Cada cue tem um início, um fim e um bloco de texto; não há campo para tempos por palavra.
O WebVTT usa cues de segmento como o SRT, mas a especificação WebVTT do W3C também permite timestamps dentro do texto da cue, como
<00:01:22.610>results. Cada um deles precisa ser posterior ao anterior e ficar dentro do início e do fim da cue. Essa é a forma padrão de expressar tempo estilo karaokê num arquivo de legenda, embora nem todo player saiba exibi-la. As vantagens e desvantagens de cada formato estão em SRT ou VTT.As transcrições em JSON são o lugar natural dos dados por palavra: arrays com palavra, início, fim e muitas vezes uma pontuação de confiança, consumidos por editores, ferramentas de corte e scripts de análise.
O DOCX e o TXT levam, no máximo, timestamps por segmento ou por turno de fala. Qualquer coisa mais fina transforma uma página feita para leitura em ruído.
Na prática: se a entrega é um arquivo que uma pessoa vai abrir, o tempo por segmento é o que deve estar nele. Se a entrega são dados que outro programa vai consumir, pode valer a pena incluir o tempo por palavra.
Qual dos dois escolher?
Transcrições, anotações, citações, capítulos, legendas comuns: por segmento. Exporte SRT ou VTT para vídeo, DOCX ou TXT para leitura.
Legendas animadas para vídeos curtos: por palavra, mas raramente é você quem lida com isso. Uma ferramenta como a Word-by-Word Captions usa o tempo das palavras internamente para criar legendas que acendem conforme cada palavra é dita (um MP4 completo com legenda gravada e sem marca d'água exige plano pago).
Player com leitura acompanhada num site: por palavra, exibido por um player como o Podcast Transcript Player, que destaca cada palavra enquanto o episódio toca.
Seu próprio software de edição, corte ou análise: JSON por palavra vindo de uma API ou de um alinhador como o WhisperX, conferido numa amostra antes de você confiar nele.
Perguntas frequentes
Qual é a diferença entre timestamps por palavra e por segmento?
Os timestamps por segmento dão um único início e fim a uma frase inteira, enquanto os timestamps por palavra dão início e fim a cada palavra. Segmentos servem para legendas e transcrições legíveis; palavras servem para recursos de software, como legendas animadas e edição pelo texto.
Timestamps por palavra são mais precisos?
São mais granulares, não mais precisos. Um bom timestamp de segmento é tão confiável quanto para encontrar um momento, e os tempos por palavra em fala ruidosa ou sobreposta muitas vezes são aproximados.
Preciso de timestamps por palavra para legendas?
Não. As cues de SRT e VTT são segmentos por definição. A exceção é o estilo de legenda palavra por palavra dos vídeos curtos, que as ferramentas geram a partir do tempo interno das palavras.
Como obter timestamps por palavra no Whisper?
Defina word_timestamps=True no Python ou passe --word_timestamps True na linha de comando; o Whisper então associa início e fim a cada palavra de cada segmento. O recurso é marcado como experimental, e o WhisperX acrescenta alinhamento forçado quando você precisa de um tempo mais justo.
Com que frequência os timestamps devem aparecer numa transcrição?
Em transcrições para leitura, a convenção comum é marcar a cada troca de falante, ou a cada 30 a 60 segundos nos monólogos longos. Os arquivos de legenda marcam o tempo de cada cue automaticamente.
Um arquivo VTT consegue guardar o tempo por palavra?
Sim. A especificação WebVTT permite timestamps dentro do texto da cue, como <00:01:22.610> antes de uma palavra, que os players podem usar para destacar no estilo karaokê. O SRT não tem nada equivalente.
Transforme suas gravações em texto que você pode usar
Envie áudio ou vídeo, cole um link do YouTube ou grave no navegador — e receba em minutos uma transcrição com identificação de falantes em mais de 120 idiomas.
Experimente o BlaBlaScribe grátisNão é necessário cartão de crédito · Armazenados na UE · Nunca usados para treinamento de IA