Znaczniki czasu w transkrypcji: poziom słowa czy segmentu i kiedy który wybrać
Dzianis Kukareka, Założyciel · Zaktualizowano
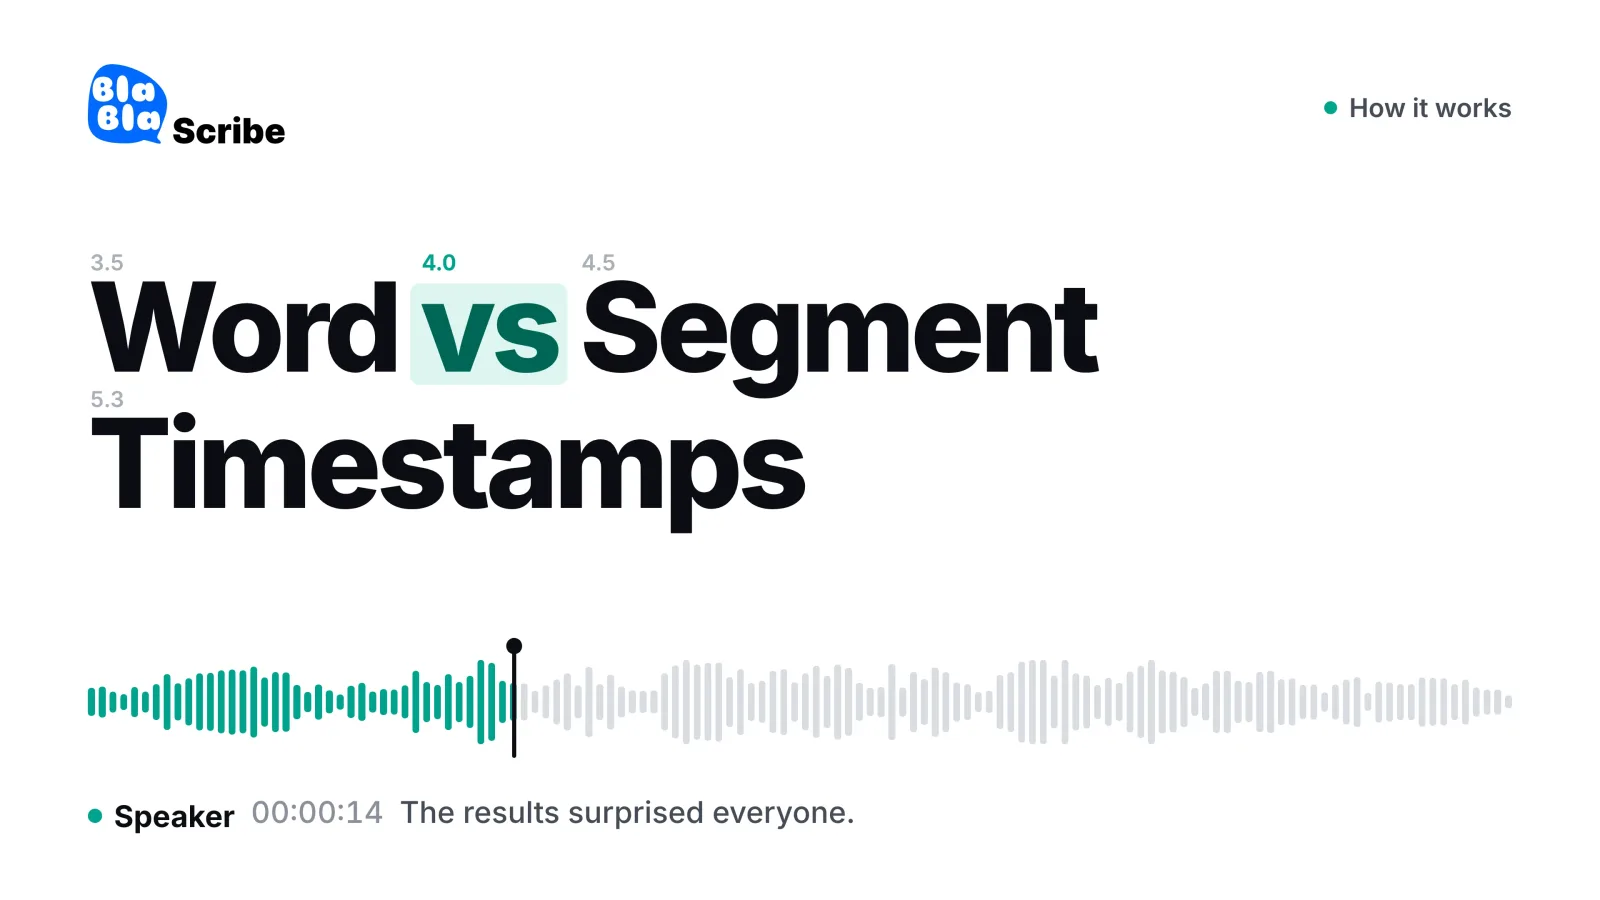
Znaczniki czasu w transkrypcji wiążą tekst z momentem, w którym padły słowa, i występują w dwóch rozdzielczościach. Znaczniki na poziomie segmentu dają każdej frazie lub zdaniu jeden czas początku i jeden czas końca. Tego potrzebują napisy, transkrypcje do weryfikacji i listy rozdziałów. Znaczniki na poziomie słowa przypisują początek i koniec każdemu pojedynczemu słowu, co ma znaczenie tylko wtedy, gdy oprogramowanie operuje na pojedynczych słowach: napisy w stylu karaoke, edycja nagrania przez tekst, precyzyjne cięcie klipów albo analityka mowy.
Jeśli nie budujesz żadnej z tych funkcji, rozsądnym domyślnym wyborem jest czas segmentów. Dalej pokazujemy, jak wygląda każdy typ, jak dodać znaczniki czasu do transkrypcji ręcznie lub automatycznie, jak narzędzia w rodzaju Whispera wyznaczają czas słów i które formaty plików potrafią go przenieść.
Co oznaczają znaczniki czasu w transkrypcji?
Oznaczanie czasu polega na wstawianiu kodów czasowych do transkrypcji, tak aby czytelnik mógł przejść z linijki tekstu do tego samego miejsca w nagraniu. Znacznik zapisuje się zwykle jako godziny, minuty i sekundy, na przykład [00:14:32], a pliki napisów dokładają milisekundy: 00:14:32.480.
Znaczniki czasu pełnią trzy funkcje. Pozwalają sprawdzić cytat z nagraniem, zacytować konkretny moment lub do niego podlinkować (rozdział, wpis w opisie odcinka, fragment w badaniu) oraz zsynchronizować tekst z dźwiękiem w odtwarzaczu lub edytorze. To, do czego ich potrzebujesz, decyduje o tym, jak gęsto powinny się pojawiać.
Jakie są rodzaje znaczników czasu w transkrypcji?
Cztery konwencje obejmują niemal każdą transkrypcję, z jaką się spotkasz. Dwie pierwsze są typowe dla transkrypcji spisywanych ręcznie, dwie ostatnie pochodzą z oprogramowania.
| Typ | Gdzie pojawia się kod czasowy | Typowe zastosowanie | Przykład |
|---|---|---|---|
| Interwałowy | W stałym rytmie, np. co 30 lub 60 sekund | Długie wywiady i wykłady, w których wystarczy orientacyjna nawigacja | [00:05:00] |
| Przy zmianie mówcy | Za każdym razem, gdy zaczyna mówić nowa osoba | Wywiady, grupy fokusowe, protokoły spotkań | [00:05:12] Anna: |
| Segmentowy (cue) | Początek i koniec każdej frazy lub zdania | Napisy, klikalne transkrypcje, rozdziały | 00:05:12.400 --> 00:05:15.900 |
| Na poziomie słowa | Początek i koniec każdego słowa | Animowane napisy, edycja przez tekst, analityka | wyniki 312.61–312.98 |
Transkrypcje badawcze często łączą dwa pierwsze typy: znacznik przy każdej zmianie mówcy plus jeden przy każdej pełnej minucie w długich monologach. Strona pozostaje czytelna, a osoba kodująca materiał znajdzie dowolny fragment w kilka sekund.
Znaczniki na poziomie słowa i segmentu: jak wyglądają
Tak wygląda jedno zdanie w rozdzielczości segmentu, w formie, której używa każdy edytor napisów:
00:01:22.400 --> 00:01:25.900
Wyniki zaskoczyły naprawdę wszystkich w całym zespole.
A tak to samo nagranie w rozdzielczości słów, w postaci, w jakiej zapisuje je typowa transkrypcja JSON (w skrócie):
[
  {"word": "Wyniki",     "start": 82.40, "end": 82.58},
  {"word": "zaskoczyły", "start": 82.61, "end": 82.98},
  {"word": "naprawdę",   "start": 83.05, "end": 83.47},
  {"word": "wszystkich", "start": 83.52, "end": 83.86},
  ...
]
Wersja segmentowa to jedna linijka, którą przeczyta człowiek. Wersja słowna to siedem rekordów, na których może działać program. Obie opisują te same 3,5 sekundy; różnią się rozdzielczością, a nie wiarygodnością.
Kiedy wystarczą znaczniki na poziomie segmentu?
W większości materiałów, które ktoś czyta lub ogląda, segment to właściwa ziarnistość.
Napisy i napisy zamknięte. Cue to segment: fraza, która zostaje na ekranie wystarczająco długo, by ją przeczytać. Wytyczne Netflixa wyznaczają na przykład minimum pięciu szóstych sekundy i maksimum siedmiu sekund na jedno zdarzenie napisowe (Netflix Timed Text Style Guide). Czas poszczególnych słów nic nie wnosi do napisu, który mieści się w tych granicach. Prawdziwa sztuka to łamanie wierszy i tempo czytania, o czym piszemy w poradniku o długości linii napisów.
Weryfikacja i cytowanie. Sprawdzenie cytatu z wywiadu albo decyzji zapisanej w protokole ze spotkania sprowadza się do kliknięcia zdania i odsłuchania go. Rozdzielczość zdania w zupełności tu wystarcza.
Rozdziały i opisy odcinków. Rozdziały na YouTube wymagają listy w opisie, która zaczyna się od
00:00, zawiera co najmniej trzy znaczniki w kolejności rosnącej, a każdy rozdział trwa co najmniej 10 sekund (Pomoc YouTube). Nikt nie potrzebuje do tego milisekundowego czasu słów.Przeszukiwanie nagrania. Wyszukiwanie, które trafia we właściwy segment, ustawia cię kilka sekund od szukanego słowa; resztę załatwia słuch.
Kiedy potrzebne są znaczniki na poziomie słowa?
Czas słów ma sens wtedy, gdy dana funkcja dosłownie nie zadziała bez niego.
Napisy słowo po słowie. Styl popularny na TikToku, w Reelsach i Shortsach, w którym każde słowo wyskakuje albo zmienia kolor w chwili wypowiedzenia, musi wiedzieć, kiedy każde słowo się zaczyna.
Transkrypcje do czytania razem z nagraniem. Odtwarzacze podcastów i wykładów, które podświetlają bieżące słowo w trakcie odtwarzania, korzystają z czasu słów.
Edycja przez tekst. Usunięcie zdania w transkrypcji tak, by dźwięk został wycięty w tym samym miejscu, wymaga dopasowania słów do audio.
Precyzyjne cięcie klipów. Automatyczne klipy, które zaczynają się dokładnie od pierwszego słowa cytatu, bez pół sekundy oddechu przed nim, korzystają z czasów początku słów.
Analityka mowy. Tempo mówienia, długość pauz i nakładanie się wypowiedzi rozmówców liczy się na podstawie czasu słów.
Prosty test: jeśli nie potrafisz wskazać funkcji, która będzie odczytywać czas poszczególnych słów, nie potrzebujesz go. Przechowywanie tych danych w większości narzędzi nic nie kosztuje, ale pokazywanie ich czytelnikom utrudnia korzystanie z transkrypcji.
Poziom słowa a poziom segmentu w skrócie
| Poziom segmentu | Poziom słowa | |
|---|---|---|
| Rozdzielczość | Fraza lub zdanie | Każde słowo |
| Formaty natywne | SRT, VTT, transkrypcje DOCX/TXT | Tablice słów w JSON, znaczniki czasu wewnątrz cue w VTT |
| Kto to czyta | Ludzie | Oprogramowanie |
| Napisy | Standard | Tylko dla animowanych stylów słownych |
| Sprawdzanie cytatów | Idealne | Zbędne |
| Edycja przez tekst, cięcie klipów | Zbyt zgrubne | Niezbędne |
| Wrażliwość na słabe nagranie | Niska: granice wypadają w pauzach | Wyższa: zlane lub nakładające się słowa dostają przybliżone czasy |
Jak dodać znaczniki czasu do transkrypcji
Jeśli spisujesz transkrypcję ręcznie, konsekwencja liczy się bardziej niż konkretna konwencja. Sprawdzona procedura:
Wybierz format raz. W dokumentach stosuj
[hh:mm:ss]w nawiasach kwadratowych. Milisekundy dodawaj tylko w plikach napisów, gdzie wymaga ich format.Wybierz regułę. Wstawiaj znacznik przy każdej zmianie mówcy, w stałych odstępach (najczęściej co 30 lub 60 sekund) albo w obu przypadkach. Zapisz regułę na początku dokumentu, żeby inni czytelnicy wiedzieli, co oznacza brak znacznika.
Odczytuj czas z odtwarzacza, nie z pamięci. Zatrzymaj nagranie, zanotuj bieżącą pozycję i wpisz ją na początku linijki.
Luki i niezrozumiałe fragmenty też oznaczaj czasem, na przykład
[niezrozumiałe 00:12:41], żeby osoba sprawdzająca mogła od razu przejść do problemu.Na koniec zrób wyrywkową kontrolę. Przeskocz do trzech, czterech znaczników i upewnij się, że tekst zgadza się z tym, co słychać.
Ręczne opisanie w ten sposób godziny nagrania zajmuje sporo czasu, dlatego większość osób pozwala dziś rozpoznawaniu mowy rozmieścić znaczniki, a sama poprawia tylko tekst. Automatyczne narzędzie do transkrypcji AI daje transkrypcję, w której każdy segment ma własny kod czasowy. Tak działa BlaBlaScribe na przesłanych plikach i linkach (na przykład przez generator transkrypcji z YouTube), z dokładnością do 99,8% przy czystym nagraniu, i eksportuje SRT, VTT, DOCX, TXT, JSON oraz inne formaty. Nie jest botem spotkań i nie dołącza do rozmów na żywo, nie ma też publicznego API, więc jeśli potrzebujesz tablic słów przesyłanych prosto do własnego oprogramowania, lepiej sprawdzi się deweloperskie API do rozpoznawania mowy.
Jak działają znaczniki czasu słów w Whisperze?
Modele mowy nie słyszą słowa w jednej chwili. Oceniają dźwięk w krótkich ramkach i emitują tokeny tekstu w miarę narastania dowodów. Znaczniki słów powstają przez odwzorowanie tych tokenów z powrotem na ramki; ten krok nazywa się wyrównaniem (alignment). Są dwa popularne sposoby.
Z mechanizmu uwagi samego modelu. Otwartoźródłowy Whisper od OpenAI ma opcję
word_timestamps, która według kodu źródłowego wyznacza znaczniki słów „using the cross-attention pattern and dynamic time warping” (Whisper, transcribe.py). Pomoc wiersza poleceń wciąż opisuje tę flagę jako eksperymentalną. Po jej włączeniu Whisper potrafi też podkreślać w wyjściu SRT i VTT każde słowo w chwili, gdy jest wypowiadane.Wymuszone wyrównanie jako drugi przebieg. Osobny model bierze gotowy tekst i nagranie, a potem szuka najlepszego dopasowania między nimi, fonem po fonemie. Tę drogę wybrał WhisperX, łącząc wykrywanie aktywności głosowej z wymuszonym wyrównaniem fonemów; jego autorzy zauważają, że znaczniki wypowiedzi w Whisperze bywają niedokładne, a znaczniki słów nie są dostępne od ręki (Bain i in., WhisperX, 2023).
Komercyjne API udostępniają tę samą ideę jako opcję zapytania. Google Cloud Speech-to-Text zwraca na przykład przesunięcia początku i końca słów, gdy enableWordTimeOffsets ma wartość true, z krokiem 100 ms (dokumentacja Google Cloud). Taka ziarnistość wystarcza do podświetlania słów, ale jest zbyt zgrubna, by bez sprawdzenia polegać na niej przy montażu dźwięku z dokładnością do klatki.
Dlaczego znaczniki czasu w Whisperze bywają niedokładne?
Zwykle winne są te same czynniki, które obniżają dokładność transkrypcji w ogóle. Mowa potoczna zaciera granice słów („gonna”, „wanna”), nakładające się głosy walczą o ten sam odcinek nagrania, muzyka i szum rozmywają początki słów, a długie cisze lub halucynowany tekst potrafią rozsynchronizować kolejne segmenty. Na trudnym nagraniu czasy słów są zwykle mniej więcej trafne dla pojedynczego słowa i wiarygodne dla całej frazy. Jeśli czas się rozjeżdża, najpierw oczyść dźwięk, podziel bardzo długie pliki i użyj narzędzia z osobnym przebiegiem wyrównania. Jeśli chcesz zajrzeć pod maskę, przeczytaj, jak naprawdę działa zamiana mowy na tekst, oraz nasze porównanie Whispera i płatnych narzędzi do transkrypcji.
Które formaty plików przenoszą znaczniki na poziomie słowa?
SRT zna tylko segmenty. Każdy cue ma jeden początek, jeden koniec i blok tekstu; nie ma pola na czas poszczególnych słów.
WebVTT używa segmentów tak jak SRT, ale specyfikacja W3C WebVTT dopuszcza też znaczniki czasu wewnątrz tekstu cue, na przykład
<00:01:22.610>wyniki. Każdy musi być późniejszy od poprzedniego i mieścić się między początkiem a końcem cue. To standardowy sposób zapisania czasu w stylu karaoke w pliku napisów, choć nie każdy odtwarzacz go wyświetla. Wady i zalety obu formatów opisujemy w tekście SRT czy VTT.Transkrypcje JSON to naturalne miejsce na dane o słowach: tablice ze słowem, początkiem, końcem i często wskaźnikiem pewności, z których korzystają edytory, narzędzia do cięcia klipów i skrypty analityczne.
DOCX i TXT przenoszą co najwyżej znaczniki segmentów lub zmian mówcy. Cokolwiek drobniejszego zamienia stronę przeznaczoną do czytania w szum.
Wniosek praktyczny: jeśli efektem pracy jest plik, który otworzy człowiek, powinien zawierać czas segmentów. Jeśli efektem są dane dla innego programu, czas słów może być wart zachowania.
Co wybrać?
Transkrypcje, notatki, cytaty, rozdziały, standardowe napisy: poziom segmentu. Do wideo eksportuj SRT lub VTT, do czytania DOCX lub TXT.
Animowane napisy do krótkich filmów: poziom słowa, choć rzadko zajmujesz się tym sam. Narzędzie takie jak Word-by-Word Captions wykorzystuje wewnętrznie czas słów, by tworzyć napisy, które rozświetlają się przy każdym wypowiedzianym słowie (pełny plik MP4 z wtopionymi napisami bez znaku wodnego wymaga płatnego planu).
Odtwarzacz z tekstem na stronie internetowej: poziom słowa, wyświetlany przez odtwarzacz taki jak Podcast Transcript Player, który podświetla każde słowo w trakcie odtwarzania odcinka.
Własne oprogramowanie do montażu, cięcia klipów lub analityki: JSON z czasem słów z API albo z narzędzia do wyrównania, takiego jak WhisperX, sprawdzony na próbce, zanim zaczniesz na nim polegać.
Najczęściej zadawane pytania
Czym różnią się znaczniki czasu na poziomie słowa i na poziomie segmentu?
Znaczniki na poziomie segmentu dają jeden czas początku i końca całej frazie lub zdaniu, a znaczniki na poziomie słowa przypisują początek i koniec każdemu słowu. Segmenty sprawdzają się w napisach i czytelnych transkrypcjach, słowa w funkcjach oprogramowania, takich jak animowane napisy czy edycja przez tekst.
Czy znaczniki na poziomie słowa są dokładniejsze?
Są bardziej szczegółowe, a nie dokładniejsze. Dobry znacznik segmentu równie pewnie pozwala znaleźć dany moment, a czasy słów przy zaszumionej lub nakładającej się mowie są często przybliżone.
Czy do napisów potrzebuję znaczników na poziomie słowa?
Nie. Cue w SRT i VTT są z założenia segmentami. Wyjątkiem jest styl napisów słowo po słowie w krótkich filmach, który narzędzia generują z wewnętrznego czasu słów.
Jak uzyskać znaczniki czasu słów z Whispera?
Ustaw word_timestamps=True w Pythonie albo przekaż --word_timestamps True w wierszu poleceń; Whisper dołączy wtedy czas początku i końca do każdego słowa w każdym segmencie. Funkcja jest oznaczona jako eksperymentalna, a gdy potrzebujesz dokładniejszego czasu, WhisperX dokłada wymuszone wyrównanie.
Jak często znaczniki czasu powinny pojawiać się w transkrypcji?
W czytelnych transkrypcjach przyjęło się wstawiać je przy każdej zmianie mówcy albo co 30–60 sekund w długich monologach. Pliki napisów oznaczają czasem każdy cue automatycznie.
Czy plik VTT może przechowywać czas słów?
Tak. Specyfikacja WebVTT dopuszcza znaczniki czasu wewnątrz tekstu cue, na przykład <00:01:22.610> przed słowem, z których odtwarzacze mogą korzystać do podświetlania w stylu karaoke. SRT nie ma odpowiednika.
Zamień swoje nagrania w tekst, z którym możesz pracować
Prześlij audio lub wideo, wklej link z YouTube albo nagraj w przeglądarce – w kilka minut otrzymasz transkrypcję z oznaczeniem mówców, w ponad 120 językach.
Wypróbuj BlaBlaScribe za darmoBez karty kredytowej · Przechowywane w UE · Nigdy nieużywane do trenowania AI