文字起こしのタイムスタンプ:単語単位とセグメント単位の違いと使い分け
Dzianis Kukareka, 創業者 · 更新日
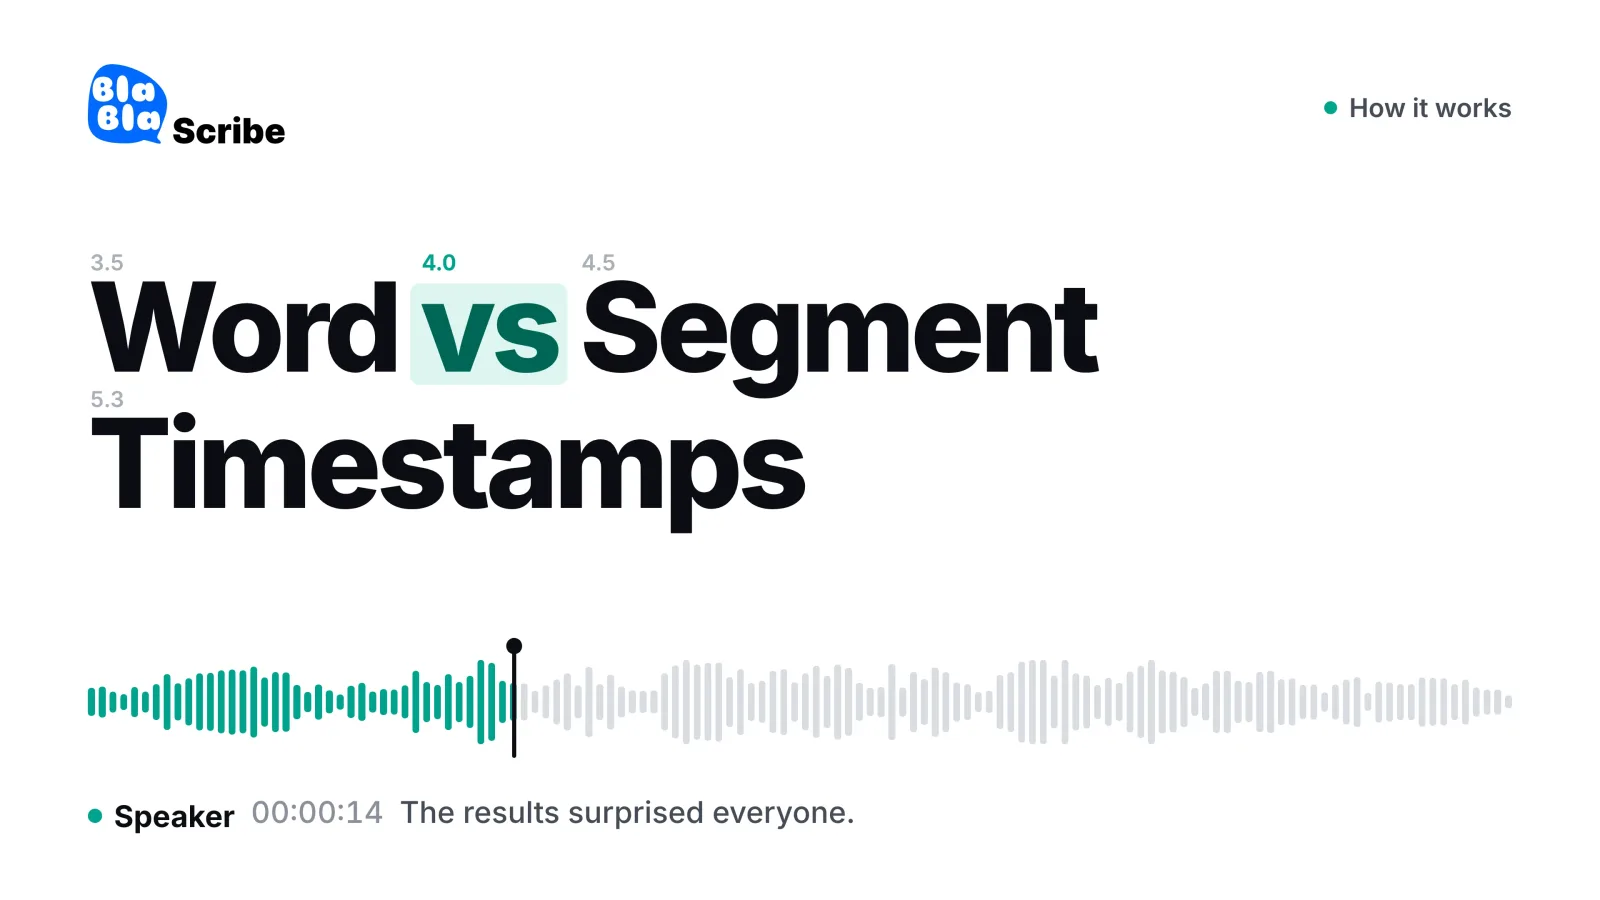
文字起こしのタイムスタンプは、テキストを「それが話された瞬間」に結びつけるもので、細かさには2つの段階があります。セグメント単位のタイムスタンプは、フレーズや文ごとに開始時刻と終了時刻を1つずつ持ちます。字幕、確認用の文字起こし、チャプター一覧に必要なのはこちらです。単語単位のタイムスタンプは、すべての単語に個別の開始・終了時刻を持たせます。意味を持つのは、ソフトウェアが単語ひとつひとつを処理する場面だけです。カラオケ風の字幕、テキストでの動画編集、正確なクリップの切り出し、音声分析などがそれにあたります。
こうした機能を自分で作るのでなければ、基本はセグメント単位で十分です。この記事では、それぞれの見た目、文字起こしにタイムスタンプを手作業または自動で入れる方法、Whisperなどのツールが単語のタイミングをどう算出しているか、そしてそれを保持できるファイル形式を順に説明します。
文字起こしのタイムスタンプとは?
タイムスタンプを入れるとは、文字起こしにタイムコードを挿入し、読み手がテキストの一行から録音の同じ位置へ飛べるようにすることです。通常は時・分・秒で [00:14:32] のように書き、字幕ファイルではミリ秒まで加えて 00:14:32.480 とします。
タイムスタンプの役割は3つあります。発言を音声と照らし合わせて確認すること、特定の瞬間を引用したりリンクしたりすること(チャプター、ショーノートの項目、研究用の抜粋など)、そしてプレーヤーや編集ソフトで文字と音を同期させることです。どの役割が必要かによって、タイムスタンプをどれくらいの密度で入れるべきかが決まります。
文字起こしのタイムスタンプにはどんな種類がある?
実際に目にする文字起こしは、ほぼ次の4つの方式のどれかです。最初の2つは人が手で打った文字起こしによく見られ、残りの2つはソフトウェアが出力するものです。
| 種類 | タイムコードが入る位置 | 主な用途 | 例 |
|---|---|---|---|
| 一定間隔 | 30秒ごと、60秒ごとなど決まったリズムで | おおまかに移動できれば十分な長いインタビューや講義 | [00:05:00] |
| 話者交代 | 別の人が話し始めるたびに | インタビュー、フォーカスグループ、会議の記録 | [00:05:12] Anna: |
| セグメント(キュー) | フレーズや文ごとの開始と終了 | 字幕、クリックできる文字起こし、チャプター | 00:05:12.400 --> 00:05:15.900 |
| 単語単位 | 単語ごとの開始と終了 | アニメーション字幕、テキストベースの編集、分析 | results 312.61–312.98 |
研究用の文字起こしでは、最初の2つを組み合わせることがよくあります。話者が交代するたびにタイムスタンプを入れ、長い独白には1分ごとにも入れるやり方です。ページは読みやすいまま、コーディングする人がどの箇所でも数秒で見つけられます。
単語単位とセグメント単位のタイムスタンプ:それぞれの見た目
まず、ある1文をセグメント単位で表したものです。字幕エディタならどれでも使われている形です。
00:01:22.400 --> 00:01:25.900
The results surprised everyone on the team.
同じ音声を単語単位で表すと、一般的なJSON形式の文字起こしでは次のように保存されます(一部省略)。
[
  {"word": "The",       "start": 82.40, "end": 82.58},
  {"word": "results",   "start": 82.61, "end": 82.98},
  {"word": "surprised", "start": 83.05, "end": 83.47},
  {"word": "everyone",  "start": 83.52, "end": 83.86},
  ...
]
セグメント版は人が読める1行で、単語版はプログラムが扱える7件のレコードです。どちらも同じ3.5秒を記述していて、違うのは細かさであって正確さではありません。
セグメント単位のタイムスタンプで十分なのはどんなとき?
人が読んだり見たりする成果物のほとんどは、セグメント単位がちょうどいい粒度です。
字幕とクローズドキャプション。キューとはセグメントのことで、読み切れるだけの時間画面に表示されるフレーズです。たとえばNetflixのスタイルガイドは、字幕1件あたりの表示時間を最短6分の5秒、最長7秒と定めています(Netflix Timed Text Style Guide)。この範囲に収まるキューに単語ごとのタイミングを足しても、得るものはありません。本当に腕が問われるのは改行位置と読む速さで、これは字幕1行の長さのガイドで解説しています。
確認と引用。インタビューの発言や議事録の決定事項を確かめるときは、文をクリックしてその部分を聞ければ用が足ります。文単位の細かさで届きます。
チャプターとショーノート。YouTubeのチャプターは、説明欄のリストが
00:00から始まり、タイムスタンプが昇順で3つ以上あり、各チャプターが10秒以上であることが条件です(YouTubeヘルプ)。ミリ秒単位の単語タイミングはまったく要りません。録音内の検索。検索で正しいセグメントにたどり着ければ、目的の語まで数秒の距離です。あとは耳で探せます。
単語単位のタイムスタンプが必要になるのはどんなとき?
単語のタイミングが本領を発揮するのは、それがなければ機能そのものが成り立たない場面です。
1語ずつ表示される字幕。TikTokやリール、ショートでおなじみの、話すのに合わせて単語が飛び出したり色が変わったりするスタイルは、各単語がいつ始まるかを知っている必要があります。
読み上げに追従する文字起こし。音声の再生に合わせて今の単語をハイライトするポッドキャストや講義のプレーヤーは、単語のタイミングをたどっています。
テキストでの編集。文字起こしの文を削除すると音声も同じ箇所でカットされる仕組みは、単語と音声の対応付けに依存しています。
ぴったりのクリップ切り出し。息継ぎを0.5秒も残さず、引用の最初の単語ちょうどから始まる自動クリップは、単語の開始時刻を使っています。
音声分析。話す速さ、間の長さ、話者同士の発話の重なりは、単語のタイミングから計算されます。
簡単な判定法があります。単語ごとのタイミングを読み取る機能の名前を挙げられないなら、それは必要ありません。多くのツールでは保存しておくだけならコストはかかりませんが、読み手に見せると文字起こしはかえって使いにくくなります。
単語単位とセグメント単位の比較表
| セグメント単位 | 単語単位 | |
|---|---|---|
| 細かさ | フレーズまたは文 | すべての単語 |
| 標準的な形式 | SRT、VTT、DOCX/TXTの文字起こし | JSONの単語配列、VTTのキュー内タイムスタンプ |
| 読むのは誰か | 人 | ソフトウェア |
| 字幕 | 標準 | 単語アニメーションのスタイルのみ |
| 発言の確認 | 最適 | 不要 |
| テキスト編集、クリップ切り出し | 粗すぎる | 必須 |
| 音質の悪さへの影響 | 小さい:区切りが間(ま)に来る | 大きい:不明瞭な単語や重なった単語は時刻が概算になる |
文字起こしにタイムスタンプを入れる方法
手で文字起こしをする場合、どの書式を選ぶかより、一貫させることのほうが大事です。実用的な手順は次のとおりです。
書式を最初に1つ決める。文書では角かっこで
[hh:mm:ss]とします。ミリ秒を加えるのは、形式上それが求められる字幕ファイルだけです。入れるタイミングを決める。話者が交代するたび、一定間隔ごと(30秒か60秒が一般的)、またはその両方です。ほかの読み手がタイムスタンプのない箇所の意味を理解できるよう、ルールを文書の冒頭に書いておきます。
時刻は記憶ではなくプレーヤーから読む。一時停止して現在位置を確認し、行の先頭に打ち込みます。
空白部分や聞き取れない箇所にも時刻を付ける。たとえば
[聞き取り不能 00:12:41]のようにしておけば、確認する人が問題の箇所へ直接飛べます。最後に抜き取りで確認する。タイムスタンプを3〜4か所選んで飛び、聞こえる内容とテキストが一致しているか確かめます。
1時間の音声をこの方法で手作業で処理するのは時間がかかります。だからこそ今は、タイムスタンプの配置は音声認識に任せ、人はテキストの修正だけをするのが一般的です。自動のAI文字起こしツールを使えば、各セグメントにタイムコードが付いた文字起こしが得られます。BlaBlaScribeはアップロードしたファイルやリンク(たとえばYouTube文字起こしジェネレーター経由)に対してこの方式で動き、クリアな音声なら最大99.8%の精度で、SRT、VTT、DOCX、TXT、JSONなどの形式に書き出せます。会議ボットではないのでライブ通話には参加せず、公開APIもありません。単語配列を自社のソフトウェアに流し込みたい場合は、開発者向けの音声APIのほうが向いています。
Whisperの単語タイムスタンプはどう算出される?
音声モデルは、単語を一瞬で聞き取っているわけではありません。音声を短いフレームに区切って評価し、手がかりがそろうにつれてテキストのトークンを出力します。単語のタイムスタンプは、そのトークンをフレームに対応させ直すことで得られます。この工程をアライメントと呼び、一般的な方法は2つあります。
モデル自身のアテンションから求める。OpenAIのオープンソースモデルWhisperには
word_timestampsというオプションがあり、ソースコードの説明によれば、クロスアテンションのパターンと動的時間伸縮法(DTW)を使って単語単位のタイムスタンプを抽出します(Whisper, transcribe.py)。コマンドラインのヘルプでは、このフラグは今も実験的機能とされています。有効にすると、WhisperはSRTやVTTの出力で、話されている単語に下線を引くこともできます。2段階目として強制アライメントを行う。別のモデルが完成したテキストと音声を受け取り、音素ごとに両者の最適な対応を探します。WhisperXはこの方法をとり、音声区間検出と音素の強制アライメントを組み合わせています。著者らは、Whisperの発話単位のタイムスタンプは不正確になりやすく、単語単位のタイムスタンプはそのままでは得られないと指摘しています(Bain et al., WhisperX, 2023)。
商用APIは同じ考え方をリクエストのオプションとして提供しています。たとえばGoogle Cloud Speech-to-Textは、enableWordTimeOffsets をtrueにすると単語の開始・終了オフセットを100ミリ秒刻みで返します(Google Cloudのドキュメント)。単語のハイライトには十分な粒度ですが、フレーム単位で正確な音声編集にそのまま使うには粗く、確認が欠かせません。
Whisperのタイムスタンプがずれることがあるのはなぜ?
主な原因は、文字起こしの精度全般を下げる要因と同じです。続けて話すと単語の境目がぼやけ(英語の「gonna」「wanna」など)、話者が重なると同じ区間の音声を取り合い、音楽や雑音は発話の立ち上がりをにじませ、長い無音や幻覚的に生成されたテキストは後続のセグメントを同期からずらします。音質の悪い音声の単語タイミングは、単語ごとにはおおよそ正しく、フレーズ単位なら信頼できる、という程度に考えておくのが妥当です。タイミングがずれる場合は、まず音声をきれいにし、非常に長いファイルは分割し、専用のアライメント処理を行うツールを使いましょう。音声認識の内部の仕組みについては音声認識の仕組みを、比較はWhisperと有料文字起こしツールの比較をご覧ください。
単語単位のタイムスタンプを保持できるファイル形式は?
SRTはセグメント専用です。各キューには開始1つ、終了1つ、テキストのまとまりがあるだけで、単語ごとの時刻を入れる欄はありません。
WebVTTはSRTと同じくセグメントのキューを使いますが、W3CのWebVTT仕様ではキューのテキスト内にもタイムスタンプを入れられます。たとえば
<00:01:22.610>resultsのような形です。各タイムスタンプは直前のものより後で、かつキューの開始と終了の間に収まっていなければなりません。字幕ファイルでカラオケ風のタイミングを表す標準的な方法ですが、すべてのプレーヤーが表示に対応しているわけではありません。2つの形式の違いはSRTとVTTの比較にまとめています。JSON形式の文字起こしは、単語データの本来の置き場所です。単語、開始、終了、多くの場合は信頼度スコアを並べた配列で、編集ソフトやクリップ作成ツール、分析スクリプトが読み込みます。
DOCXとTXTが持てるのは、せいぜいセグメントか話者交代ごとのタイムスタンプです。それより細かくすると、読むためのページがノイズだらけになります。
実務的な結論はこうです。成果物が人の開くファイルなら、入れるべきはセグメント単位のタイミングです。成果物が別のプログラムに読み込ませるデータなら、単語単位のタイミングを持たせる価値があるかもしれません。
結局どちらを選べばいい?
文字起こし、メモ、引用、チャプター、通常の字幕:セグメント単位。動画用ならSRTかVTT、読む用ならDOCXかTXTで書き出します。
ショート動画のアニメーション字幕:単語単位ですが、自分で扱うことはまずありません。Word-by-Word Captionsのようなツールは内部で単語のタイミングを使い、話すのに合わせて1語ずつ光る字幕を作ります(透かしなしで字幕を焼き込んだMP4を丸ごと書き出すには有料プランが必要です)。
Webサイトの読み上げ追従プレーヤー:単語単位。Podcast Transcript Playerのようなプレーヤーが表示し、エピソードの再生に合わせて単語を1つずつハイライトします。
自社の編集・切り出し・分析ソフトウェア:APIやWhisperXのようなアライナーから得た単語単位のJSON。本格的に頼る前にサンプルで確認しましょう。
よくある質問
単語単位とセグメント単位のタイムスタンプの違いは?
セグメント単位のタイムスタンプはフレーズや文全体に開始・終了時刻を1つずつ付け、単語単位のタイムスタンプはすべての単語に開始・終了時刻を付けます。セグメントは字幕や読みやすい文字起こしに、単語はアニメーション字幕やテキスト編集といったソフトウェアの機能に向いています。
単語単位のタイムスタンプのほうが正確なのですか?
細かいだけで、正確なわけではありません。ある瞬間を探すという目的なら、よくできたセグメントのタイムスタンプも同じくらい信頼でき、雑音や発話の重なりがある音声では単語の時刻は概算になりがちです。
字幕に単語単位のタイムスタンプは必要ですか?
いいえ。SRTやVTTのキューはもともとセグメントです。例外はショート動画向けの1語ずつ表示する字幕スタイルですが、これはツールが内部の単語タイミングから生成します。
Whisperで単語のタイムスタンプを取得するには?
Pythonでは word_timestamps=True を指定し、コマンドラインでは --word_timestamps True を渡します。するとWhisperは各セグメント内の単語ごとに開始・終了時刻を付けます。この機能は実験的とされており、より正確なタイミングが必要ならWhisperXが強制アライメントを追加してくれます。
文字起こしにはどれくらいの頻度でタイムスタンプを入れるべき?
読むための文字起こしなら、話者が交代するたび、長い独白なら30〜60秒ごとに入れるのが一般的です。字幕ファイルでは、すべてのキューに自動でタイムスタンプが付きます。
VTTファイルは単語単位のタイミングを保持できますか?
はい。WebVTT仕様ではキューのテキスト内にタイムスタンプを入れることができ、たとえば単語の前に <00:01:22.610> と書けば、プレーヤーはカラオケ風のハイライトに利用できます。SRTには同等の仕組みがありません。
録音をすぐに使えるテキストに変える
音声や動画をアップロード、YouTubeリンクを貼り付け、またはブラウザで録音するだけで、話者ラベル付きの文字起こしが120以上の言語で数分で手に入ります。
BlaBlaScribeを無料で試すクレジットカード不要・EU内で保存・AI学習には一切使用しません