단어 단위 타임스탬프 vs 문장 단위: 녹취록 타임스탬프 종류와 쓰임
Dzianis Kukareka, 창업자 · 업데이트
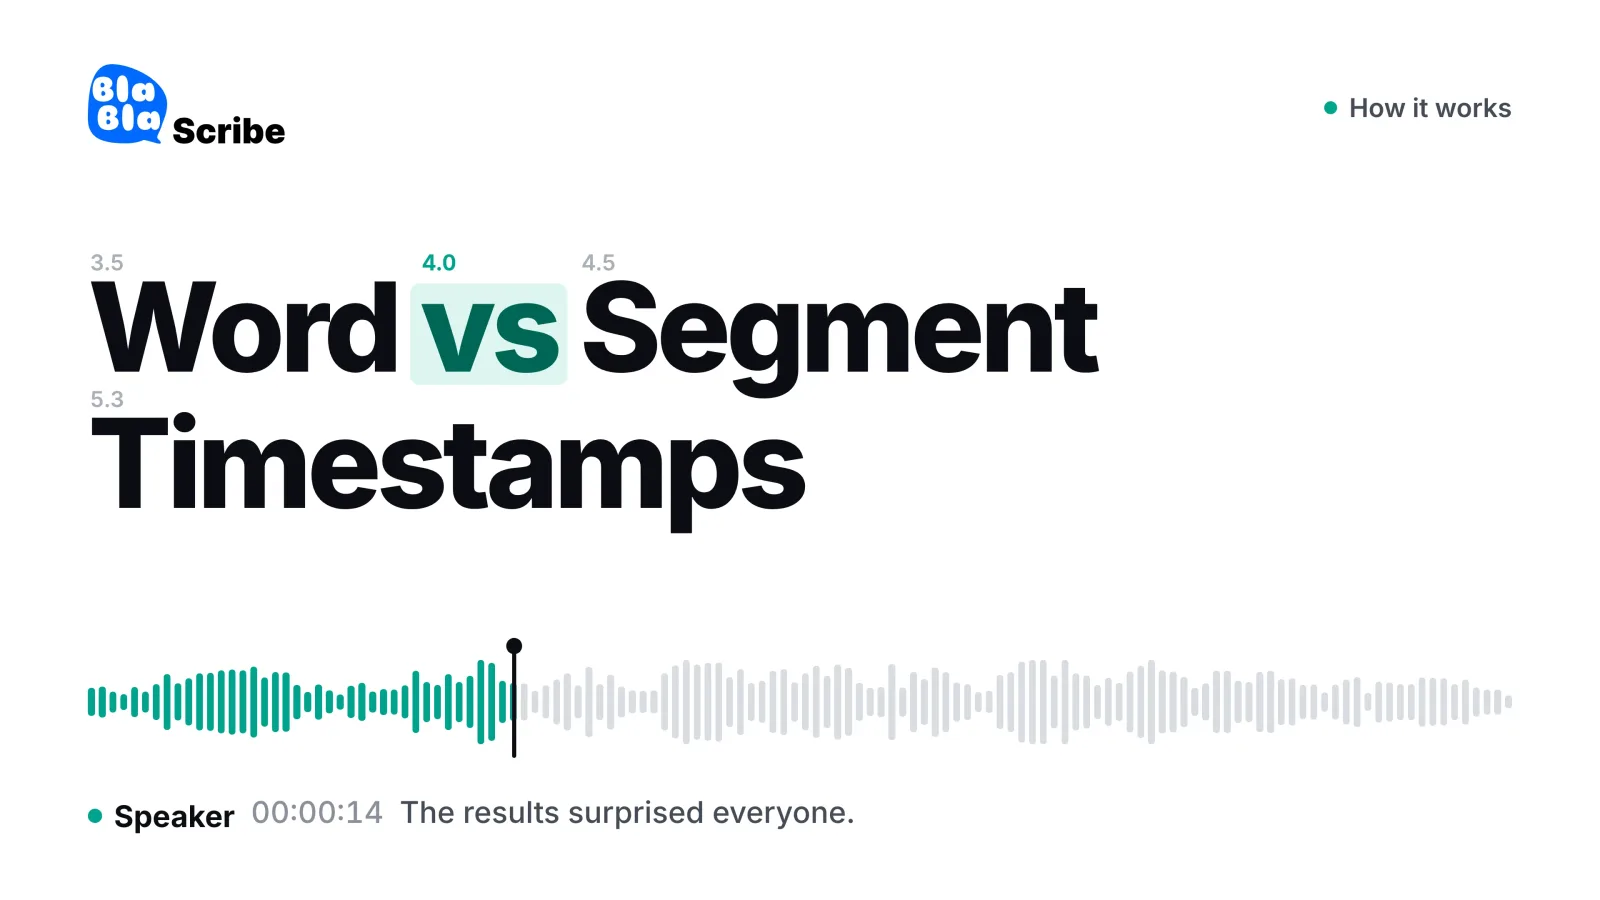
녹취록의 타임스탬프는 텍스트를 그 말이 나온 순간에 묶어 주는 표시이고, 해상도는 두 가지입니다. 문장 단위(세그먼트) 타임스탬프는 구절이나 문장마다 시작과 끝 시각을 하나씩 붙입니다. 자막, 검토용 녹취록, 챕터 목록에 필요한 것이 바로 이 방식입니다. 단어 단위 타임스탬프는 단어 하나하나에 시작과 끝을 따로 붙이는데, 이것이 의미를 갖는 경우는 소프트웨어가 개별 단어를 다룰 때뿐입니다. 노래방식 자막, 텍스트로 편집하기, 정밀한 클립 컷, 음성 분석이 그런 예입니다.
이런 기능을 직접 만드는 게 아니라면 기본값은 문장 단위로 충분합니다. 아래에서는 두 방식이 실제로 어떻게 생겼는지, 녹취록에 타임스탬프를 손으로 또는 자동으로 넣는 방법, Whisper 같은 도구가 단어 타이밍을 만드는 원리, 그리고 이를 담을 수 있는 파일 형식을 차례로 정리합니다.
녹취록에서 타임스탬프란 무슨 뜻일까?
타임스탬프를 넣는다는 것은 녹취록에 시간 코드를 삽입해, 읽는 사람이 텍스트 한 줄에서 녹음의 같은 지점으로 바로 이동할 수 있게 만드는 일입니다. 보통 시·분·초로 적으며 [00:14:32]처럼 쓰고, 자막 파일은 여기에 밀리초를 더해 00:14:32.480처럼 표기합니다.
타임스탬프가 하는 일은 세 가지입니다. 인용문을 원본 오디오와 대조할 수 있게 하고, 특정 순간을 인용하거나 링크할 수 있게 하며(챕터, 쇼노트 항목, 연구 발췌문), 플레이어나 편집기가 텍스트와 소리를 맞출 수 있게 합니다. 어떤 일이 필요한지에 따라 타임스탬프를 얼마나 촘촘하게 넣어야 할지가 정해집니다.
녹취록 타임스탬프에는 어떤 종류가 있을까?
실제로 접하는 녹취록은 거의 다 네 가지 방식 중 하나입니다. 앞의 두 가지는 사람이 직접 타이핑한 녹취록에서 흔하고, 뒤의 두 가지는 소프트웨어가 만듭니다.
| 종류 | 시간 코드가 붙는 위치 | 주된 용도 | 예시 |
|---|---|---|---|
| 일정 간격 | 30초나 60초마다처럼 고정된 주기 | 대략적인 위치만 찾으면 되는 긴 인터뷰와 강의 | [00:05:00] |
| 화자 전환 | 새로운 사람이 말을 시작할 때마다 | 인터뷰, 포커스 그룹, 회의 기록 | [00:05:12] Anna: |
| 문장(큐) 단위 | 모든 구절이나 문장의 시작과 끝 | 자막, 클릭 가능한 녹취록, 챕터 | 00:05:12.400 --> 00:05:15.900 |
| 단어 단위 | 모든 단어의 시작과 끝 | 애니메이션 자막, 텍스트 기반 편집, 분석 | results 312.61–312.98 |
연구용 녹취록은 앞의 두 방식을 섞는 경우가 많습니다. 화자가 바뀔 때마다 타임스탬프를 달고, 긴 독백에는 1분마다 하나씩 더하는 식입니다. 이렇게 하면 문서는 읽기 쉬우면서도 코딩 담당자가 어떤 구간이든 몇 초 만에 찾을 수 있습니다.
단어 단위 vs 문장 단위 타임스탬프: 실제 모습
먼저 문장 하나를 세그먼트 해상도로 표시하면 다음과 같습니다. 모든 자막 편집기가 쓰는 형태입니다.
00:01:22.400 --> 00:01:25.900
The results surprised everyone on the team.
같은 오디오를 단어 해상도로 표시하면 일반적인 JSON 녹취록에는 이렇게 저장됩니다(일부 생략).
[
  {"word": "The",       "start": 82.40, "end": 82.58},
  {"word": "results",   "start": 82.61, "end": 82.98},
  {"word": "surprised", "start": 83.05, "end": 83.47},
  {"word": "everyone",  "start": 83.52, "end": 83.86},
  ...
]
세그먼트 버전은 사람이 읽을 수 있는 한 줄이고, 단어 버전은 프로그램이 처리할 수 있는 레코드 일곱 개입니다. 둘 다 똑같은 3.5초를 설명합니다. 차이는 해상도에 있지, 어느 쪽이 더 정확하냐에 있지 않습니다.
문장 단위 타임스탬프로 충분한 경우는?
사람이 읽거나 보는 결과물이라면 대부분 세그먼트가 맞는 단위입니다.
자막과 폐쇄 자막. 자막 큐 하나가 곧 세그먼트입니다. 읽을 수 있을 만큼 화면에 머무는 구절이죠. 예를 들어 Netflix 스타일 가이드는 자막 이벤트 하나당 최소 6분의 5초, 최대 7초를 기준으로 둡니다(Netflix Timed Text Style Guide). 이 기준을 지키는 큐라면 단어별 타이밍은 보탤 게 없습니다. 진짜 기술은 줄바꿈과 읽기 속도에 있고, 이는 자막 한 줄 길이 가이드에서 다룹니다.
검토와 인용. 인터뷰 속 인용문이나 회의록의 결정 사항을 확인할 때는 문장을 클릭해서 들어 보면 됩니다. 문장 해상도면 거기까지 충분히 갑니다.
챕터와 쇼노트. YouTube 챕터를 만들려면 설명란 목록이
00:00에서 시작하고, 타임스탬프가 오름차순으로 세 개 이상 있어야 하며, 각 챕터는 10초 이상이어야 합니다(YouTube 고객센터). 여기에 밀리초 단위의 단어 타이밍이 필요한 사람은 없습니다.녹음 내용 검색. 검색 결과가 해당 세그먼트로 데려다주면 찾는 단어와 몇 초 이내 거리에 있게 됩니다. 나머지는 귀가 알아서 해 줍니다.
단어 단위 타임스탬프가 꼭 필요한 경우는?
단어 타이밍은 그것 없이는 기능 자체가 돌아가지 않을 때 비로소 제 몫을 합니다.
단어별 자막. TikTok, 릴스, 쇼츠에서 흔히 보는, 말하는 순간 단어가 하나씩 튀어나오거나 색이 바뀌는 스타일은 각 단어가 언제 시작하는지 알아야 합니다.
따라 읽기 녹취록. 오디오가 재생되는 동안 현재 단어를 강조하는 팟캐스트·강의 플레이어는 단어 시각을 따라갑니다.
텍스트로 편집하기. 녹취록에서 문장을 지우면 오디오도 같은 자리에서 잘리는 기능은 단어와 오디오의 정렬에 의존합니다.
정밀한 클립 컷. 앞에 0.5초짜리 숨소리 없이 인용문의 첫 단어에서 정확히 시작하는 자동 클립은 단어 시작 시각을 씁니다.
음성 분석. 말하는 속도, 쉼의 길이, 화자 간 겹침은 단어 시각으로 계산합니다.
간단한 판별법이 있습니다. 단어별 시각을 읽어 들일 기능의 이름을 댈 수 없다면, 그건 필요 없는 겁니다. 대부분의 도구에서 일단 저장해 두는 데는 비용이 들지 않지만, 독자에게 보여 주면 녹취록이 오히려 쓰기 불편해집니다.
단어 단위 vs 문장 단위 한눈에 비교
| 문장 단위 | 단어 단위 | |
|---|---|---|
| 해상도 | 구절 또는 문장 | 모든 단어 |
| 기본 형식 | SRT, VTT, DOCX/TXT 녹취록 | JSON 단어 배열, VTT 큐 내부 타임스탬프 |
| 읽는 주체 | 사람 | 소프트웨어 |
| 자막 | 표준 | 단어 애니메이션 스타일에만 필요 |
| 인용 확인 | 최적 | 불필요 |
| 텍스트 편집, 클립 컷 | 너무 거침 | 필수 |
| 지저분한 오디오에 대한 민감도 | 낮음: 경계가 쉼에 놓임 | 높음: 뭉개지거나 겹친 단어는 대략적인 시각을 받음 |
녹취록에 타임스탬프 넣는 방법
녹취록을 손으로 타이핑한다면, 어떤 규칙을 쓰느냐보다 한 가지 규칙을 일관되게 지키는 것이 더 중요합니다. 실제로 쓸 만한 절차는 이렇습니다.
형식을 한 번만 정합니다. 문서에는 대괄호 안에
[hh:mm:ss]를 씁니다. 밀리초는 형식상 반드시 필요한 자막 파일에만 넣습니다.넣는 기준을 정합니다. 화자가 바뀔 때마다, 일정 간격마다(30초나 60초가 흔합니다), 또는 둘 다에 타임스탬프를 답니다. 문서 맨 위에 규칙을 적어 두면 다른 사람도 타임스탬프가 없는 곳이 무슨 뜻인지 압니다.
시각은 기억이 아니라 플레이어에서 읽습니다. 일시정지하고 현재 위치를 확인한 뒤 줄 맨 앞에 입력합니다.
공백이나 알아듣기 어려운 구간에도 시각을 표시합니다. 예를 들어
[청취 불가 00:12:41]처럼 적어 두면 검토자가 문제 지점으로 곧장 갈 수 있습니다.마지막에 무작위로 확인합니다. 타임스탬프 서너 개로 이동해 들리는 내용과 텍스트가 맞는지 봅니다.
한 시간 분량을 손으로 하면 시간이 꽤 걸립니다. 그래서 요즘은 대부분 음성 인식에 타임스탬프 배치를 맡기고 텍스트만 고칩니다. 자동 AI 녹취 도구를 쓰면 세그먼트마다 시간 코드가 붙은 녹취록이 나옵니다. BlaBlaScribe도 업로드한 파일과 링크로 이렇게 동작하며(예: YouTube 스크립트 추출기), 깨끗한 오디오에서 최대 99.8%의 정확도를 내고 SRT, VTT, DOCX, TXT, JSON 등으로 내보낼 수 있습니다. 다만 회의 봇이 아니어서 실시간 통화에 참여하지 않고, 공개 API도 없습니다. 단어 배열을 자체 소프트웨어로 스트리밍해야 한다면 개발자용 음성 API가 더 잘 맞습니다.
Whisper 단어 타임스탬프는 어떻게 만들어질까?
음성 모델은 단어를 어느 한순간에 듣지 않습니다. 오디오를 짧은 프레임 단위로 평가하고, 근거가 쌓이면 텍스트 토큰을 내놓습니다. 단어 타임스탬프는 그 토큰을 다시 프레임에 대응시키는 과정, 즉 정렬(alignment)에서 나옵니다. 흔히 쓰는 방법은 두 가지입니다.
모델 자체의 어텐션을 이용하는 방법. OpenAI의 오픈소스 Whisper에는
word_timestamps옵션이 있는데, 소스 코드 설명에 따르면 "cross-attention pattern and dynamic time warping"을 이용해 단어 단위 타임스탬프를 추출합니다(Whisper, transcribe.py). 명령줄 도움말에는 지금도 이 플래그가 실험적 기능으로 표시되어 있습니다. 이 옵션을 켜면 Whisper는 SRT와 VTT 출력에서 말하는 순간 단어마다 밑줄을 그어 줄 수도 있습니다.두 번째 단계로 강제 정렬을 하는 방법. 별도의 모델이 완성된 텍스트와 오디오를 받아 음소 단위로 둘 사이의 가장 잘 맞는 위치를 찾습니다. WhisperX가 이 방식으로, 음성 구간 검출과 강제 음소 정렬을 결합합니다. 저자들은 Whisper의 발화 타임스탬프가 부정확해지기 쉽고 단어 단위 타임스탬프는 기본으로 제공되지 않는다고 지적합니다(Bain et al., WhisperX, 2023).
상용 API는 같은 개념을 요청 옵션으로 제공합니다. 예를 들어 Google Cloud Speech-to-Text는 enableWordTimeOffsets를 true로 설정하면 단어의 시작과 끝 오프셋을 100 ms 단위로 돌려줍니다(Google Cloud 문서). 단어 강조에는 충분한 정밀도지만, 프레임 단위로 정확해야 하는 오디오 편집에 확인 없이 믿고 쓰기에는 거칩니다.
Whisper 타임스탬프가 가끔 부정확한 이유는?
원인은 대개 음성 인식 정확도를 떨어뜨리는 요인과 같습니다. 이어서 빠르게 말하면 단어 경계가 흐려지고("gonna", "wanna"), 화자가 겹치면 같은 구간을 두고 경쟁하며, 음악과 소음은 단어의 시작점을 번지게 하고, 긴 침묵이나 환각으로 생긴 텍스트는 뒤쪽 세그먼트의 싱크를 밀어냅니다. 지저분한 오디오에서 단어 시각은 단어별로는 대략 맞고 구절 단위로는 믿을 만한 편입니다. 타이밍이 어긋난다면 먼저 오디오를 정리하고, 아주 긴 파일은 나누고, 별도의 정렬 단계를 거치는 도구를 쓰세요. 음성 인식이 내부에서 어떻게 동작하는지는 음성 텍스트 변환의 실제 원리와 Whisper와 유료 녹취 도구 비교에서 더 볼 수 있습니다.
단어 단위 타임스탬프를 담을 수 있는 파일 형식은?
SRT는 세그먼트 전용입니다. 큐마다 시작 하나, 끝 하나, 텍스트 블록이 있을 뿐 단어별 시각을 넣을 칸이 없습니다.
WebVTT는 SRT처럼 세그먼트 큐를 쓰지만, W3C WebVTT 명세는 큐 텍스트 안에
<00:01:22.610>results같은 큐 타임스탬프도 허용합니다. 각 타임스탬프는 앞의 것보다 늦어야 하고 큐의 시작과 끝 사이에 있어야 합니다. 자막 파일에서 노래방식 타이밍을 표현하는 표준 방법이지만, 모든 플레이어가 이를 렌더링하지는 않습니다. 두 형식의 장단점은 SRT vs VTT에 정리해 두었습니다.JSON 녹취록은 단어 데이터의 자연스러운 보관 형식입니다. 단어, 시작, 끝, 그리고 흔히 신뢰도 점수까지 담은 배열을 편집기, 클립 도구, 분석 스크립트가 가져다 씁니다.
DOCX와 TXT에는 많아야 세그먼트나 화자 전환 타임스탬프까지만 들어갑니다. 그보다 촘촘하면 읽으라고 만든 문서가 잡음이 됩니다.
실무적으로 정리하면, 결과물이 사람이 여는 파일이라면 문장 단위 타이밍이 맞습니다. 다른 프로그램이 가져다 쓰는 데이터라면 단어 타이밍을 담아 둘 가치가 있을 수 있습니다.
무엇을 선택해야 할까?
녹취록, 메모, 인용, 챕터, 일반 자막: 문장 단위. 영상용은 SRT나 VTT, 읽기용은 DOCX나 TXT로 내보냅니다.
숏폼 영상용 애니메이션 자막: 단어 단위지만 직접 다룰 일은 거의 없습니다. 단어별 자막 같은 도구가 내부적으로 단어 타이밍을 써서 말하는 순간 단어마다 불이 들어오는 자막을 만들어 줍니다(워터마크 없이 자막을 입힌 전체 MP4는 유료 요금제가 필요합니다).
웹사이트의 따라 읽기 플레이어: 단어 단위. 팟캐스트 스크립트 플레이어 같은 플레이어가 에피소드 재생에 맞춰 단어를 하나씩 강조해 줍니다.
자체 편집·클립·분석 소프트웨어: API나 WhisperX 같은 정렬 도구에서 받은 단어 단위 JSON. 실제로 쓰기 전에 샘플로 먼저 검증하세요.
자주 묻는 질문
단어 단위 타임스탬프와 문장 단위 타임스탬프는 무엇이 다른가요?
문장 단위 타임스탬프는 구절이나 문장 전체에 시작·끝 시각을 하나씩 주고, 단어 단위 타임스탬프는 모든 단어에 시작·끝 시각을 줍니다. 문장 단위는 자막과 읽기 쉬운 녹취록에, 단어 단위는 애니메이션 자막이나 텍스트 편집 같은 소프트웨어 기능에 맞습니다.
단어 단위 타임스탬프가 더 정확한가요?
더 세밀할 뿐, 더 정확한 것은 아닙니다. 잘 잡힌 세그먼트 타임스탬프도 특정 순간을 찾는 데는 똑같이 믿을 만하고, 잡음이 있거나 겹친 음성에서 단어 시각은 대략적인 경우가 많습니다.
자막에 단어 단위 타임스탬프가 필요한가요?
아닙니다. SRT와 VTT 큐는 애초에 세그먼트로 설계되어 있습니다. 예외는 숏폼 영상의 단어별 자막 스타일인데, 이건 도구가 내부 단어 타이밍으로 만들어 줍니다.
Whisper에서 단어 타임스탬프를 얻으려면 어떻게 하나요?
Python에서는 word_timestamps=True를 설정하고, 명령줄에서는 --word_timestamps True를 넘기면 됩니다. 그러면 Whisper가 각 세그먼트의 단어마다 시작·끝 시각을 붙입니다. 이 기능은 실험적 기능으로 표시되어 있으며, 더 정밀한 타이밍이 필요하면 WhisperX가 강제 정렬을 더해 줍니다.
녹취록에는 타임스탬프를 얼마나 자주 넣어야 하나요?
읽기용 녹취록이라면 화자가 바뀔 때마다, 긴 독백은 30~60초마다 넣는 것이 흔한 관례입니다. 자막 파일은 큐마다 자동으로 타임스탬프가 붙습니다.
VTT 파일에 단어 단위 타이밍을 담을 수 있나요?
네. WebVTT 명세는 단어 앞에 <00:01:22.610>처럼 큐 텍스트 안에 큐 타임스탬프를 넣는 것을 허용하고, 플레이어는 이를 노래방식 강조에 쓸 수 있습니다. SRT에는 이에 해당하는 기능이 없습니다.
녹음을 바로 활용할 수 있는 텍스트로 바꾸세요
오디오나 동영상을 업로드하거나 YouTube 링크를 붙여넣거나 브라우저에서 녹음하면, 120개 이상의 언어로 화자 구분이 된 전사본을 몇 분 만에 받을 수 있습니다.
BlaBlaScribe 무료로 사용해 보기신용카드 불필요 · EU 내 저장 · AI 학습에 사용 안 함